阿楠 ANAN Personal Technology Lab · 个人技术实验室
2026 / 11

Projects · 04 · 示例内容·可替换

项目

四个落地并长期运行的后端系统。每篇按同一顺序写:当时的约束、具体做法、以及后来的数字。 判断有误的地方也保留,标在原处。

全部为线上系统
2021 — 2026
更新于 2026.11
2023— 至今
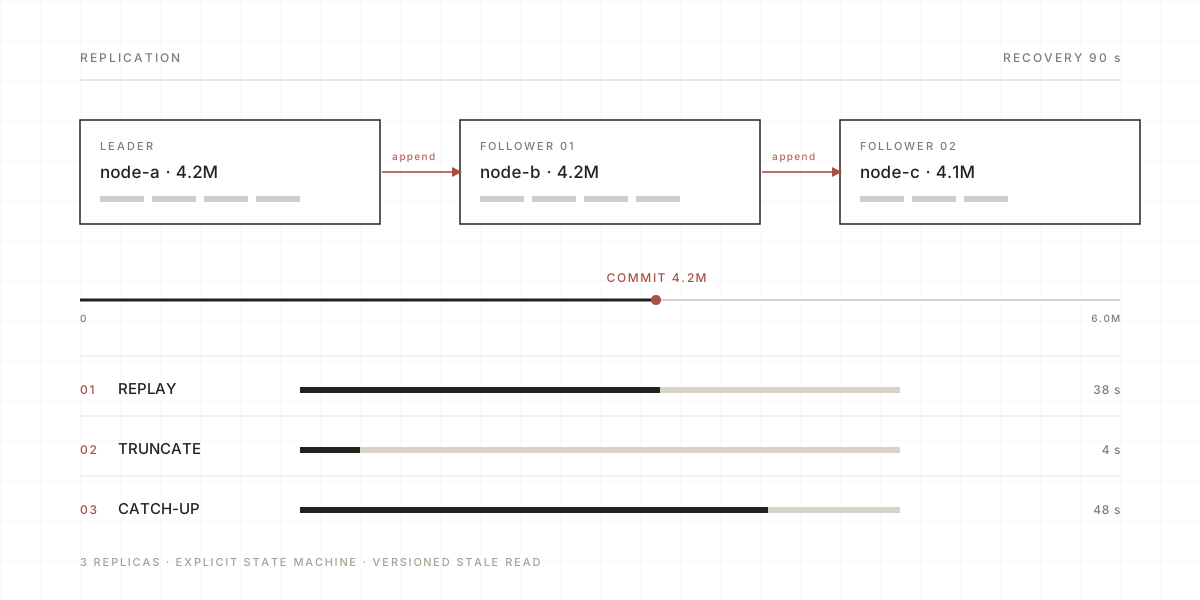
汤谷示意图:三个副本节点、提交索引,以及重放、截断、追上三段恢复进度
FIG 01 — 三副本日志、提交索引与恢复三段

汤谷Tonggu运行中

约束

调度与配额的状态原本散在三个服务里,各写一份。平时看不出问题,一次机房断电之后三份状态对不上账, 恢复只能靠人拿脚本逐条比对,用了四十二分钟。要求很明确:重启之后,副本必须能自证状态。

做法

状态收进带副本的存储,恢复写成显式的三段状态机:重放本地日志、截掉未提交的尾巴、再追上领先的节点。 日志先落本地环形缓冲再批量提交,掉电最多丢一个批次,丢了多少可查;读路径允许旧读,但结果带可比较的版本号。

结果

恢复时间从四十二分钟降到一分半,且每一步都有独立进度。后来又发现一个判断错了: 原以为「先追平再对外」更安全,实际让恢复期多停了一倍时间,改成「追上六成就可服务」。

Recovery
42 min → 90 s
Uptime
99.98%
Scale
32 节点 · 4 TB
Role
技术负责人
Stack
Rust · Raft · RocksDB
Since
2023.04
2022— 2024
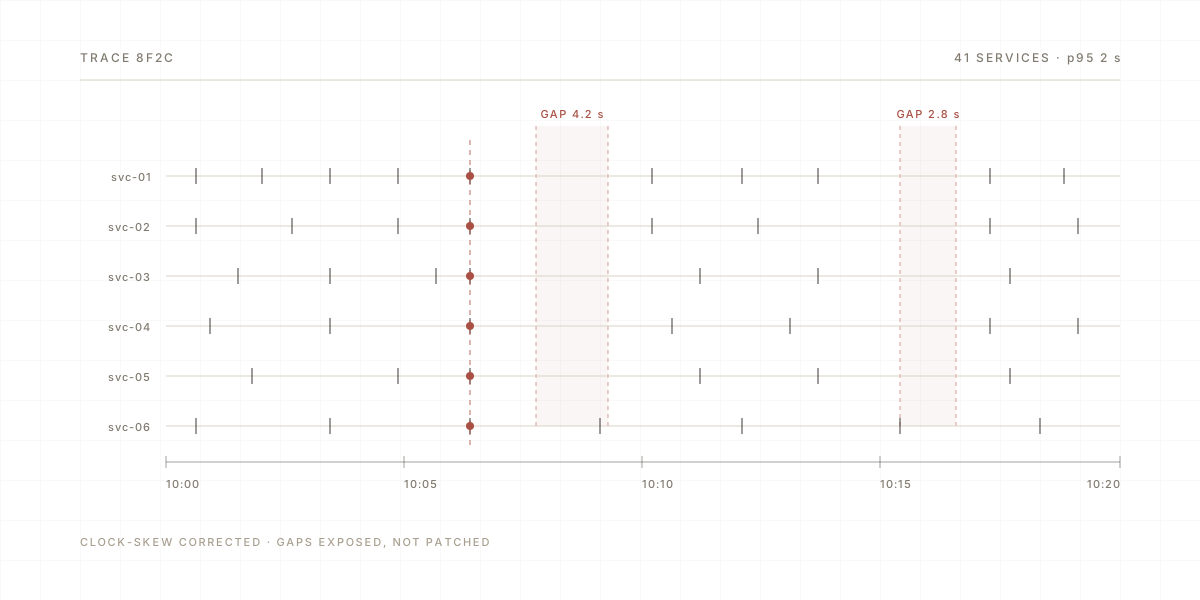
十日示意图:六个服务的日志泳道、一条被追踪的请求,以及两段标出的日志缺口
FIG 02 — 多服务时间线与缺口视图

十日Ten Suns运行中

约束

四十多个服务各写各的日志,字段命名不统一。出事时最常听到的一句话是「这条日志为什么没出来」, 而没人答得上来——因为「没发生」和「没采到」在界面上长得一样。

做法

采集端统一注入请求标识与时钟偏移,查询侧按修正后的时间把多个服务排成一条时间线; 采样按错误率动态调整,正常路径少存、异常路径全留;再加一个缺口视图,把本该有日志却空着的区间直接画出来。

结果

平均定位时间从三个半小时降到四十分钟。最意外的是缺口视图的副作用:它把「上游压根没调用」这类问题 也变成了可见的事实,于是一批「疑似中间件丢日志」的工单自己消失了。

MTTD
3.5 h → 40 min
Throughput
3.2 亿行 / 日
p95
< 2 s
Role
设计与实现
Stack
Go · Kafka · ClickHouse
Since
2022.08
2021— 2022
木纹示意图:由实体、维度、版本组成的缓存键,以及命中率从 71% 到 94% 的对比
FIG 03 — 键的三段结构与命中率

木纹Woodgrain已归档

约束

缓存键一开始只写到实体。后来业务多出「按区域」「按会员等级」的差异,于是每来一次需求, 就要在缓存层里改一遍键的拼法。半年下来同一份数据存了四个版本,命中率停在 71%。

做法

把键拆成三段:实体、可增长的维度数组、单调递增的版本号。写入侧负责失效,读取侧只校验; 旧键保留一个兼容版本,迁移期间两套并存但只读旧键。

结果

命中率到了 94%,缓存层代码少了六成。事后回看,最初的判断是错的:我以为瓶颈在淘汰策略, 换了两套 LRU 变体都没用,问题其实一直在键的结构上。

Hit rate
71% → 94%
Code
-60%
p99
48 ms → 21 ms
Role
改造负责人
Stack
Go · Redis · PostgreSQL
Since
2021.11
2024— 至今
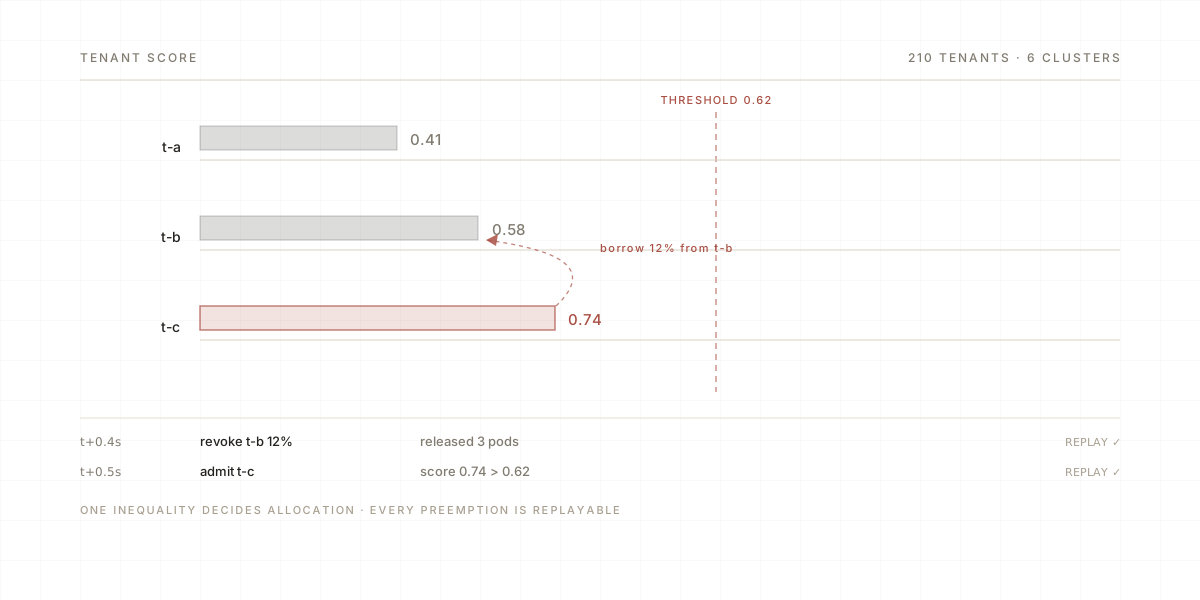
玄鸟示意图:三个租户的调度分数、0.62 阈值线,以及可重放的抢占记录
FIG 04 — 租户分数、阈值与抢占记录

玄鸟Xuanniao在研

约束

多租户各有一套限额逻辑,冲突时靠人协调。更麻烦的是抢占决定无从复现: 同一个请求,昨天排进去,今天排不进去,没人说得清差在哪。

做法

把租户权重、借用额度和回收阈值合成一个可比较的分数,调度只比分数;借用可撤销, 高优先级任务到达时按逆序收回;每次抢占留一条可重放的记录,事后能复现当时的排序。

结果

协调工单少了八成半,抢占 100% 可复现。仍在研的是跨集群借用——现在的分数只在集群内比较, 跨集群要把网络代价折进来,这部分还没定。

Tickets
-85%
Replay
100%
Scale
210 租户 · 6 集群
Role
核心开发者
Stack
Rust · gRPC · etcd
Since
2024.06