2023— 至今
汤谷Tonggu运行中
约束
调度与配额的状态原本散在三个服务里,各写一份。平时看不出问题,一次机房断电之后三份状态对不上账, 恢复只能靠人拿脚本逐条比对,用了四十二分钟。要求很明确:重启之后,副本必须能自证状态。
做法
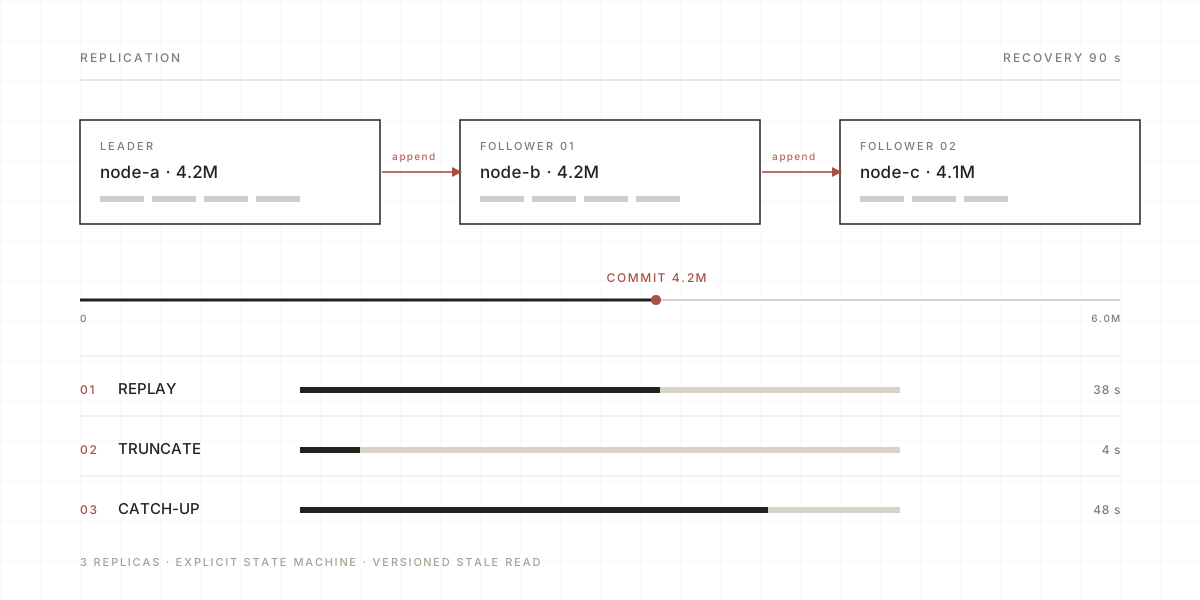
状态收进带副本的存储,恢复写成显式的三段状态机:重放本地日志、截掉未提交的尾巴、再追上领先的节点。 日志先落本地环形缓冲再批量提交,掉电最多丢一个批次,丢了多少可查;读路径允许旧读,但结果带可比较的版本号。
结果
恢复时间从四十二分钟降到一分半,且每一步都有独立进度。后来又发现一个判断错了: 原以为「先追平再对外」更安全,实际让恢复期多停了一倍时间,改成「追上六成就可服务」。
- Recovery
- 42 min → 90 s
- Uptime
- 99.98%
- Scale
- 32 节点 · 4 TB
- Role
- 技术负责人
- Stack
- Rust · Raft · RocksDB
- Since
- 2023.04